AI 驱动文档
您想了解什么?
持续改进您的模型
您的检测已部署。那么,当条件发生变化、出现新的缺陷类型或规格演变时,如何保持其良好性能?
库:您的持续改进工具
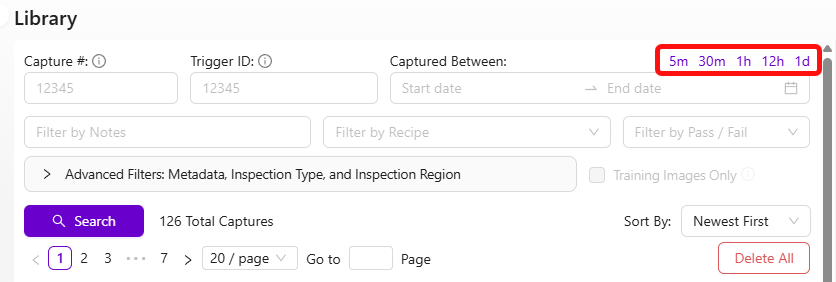
相机捕获的每张图像都会保存在库中,同时保存 AI 的预测结果和置信度分数。这是您改进模型的金矿。
查找 AI 出错的地方
- 进入库
- 浏览最近的捕获
- 关注两类情况:
- **错判:**AI 的预测明显错误的图像(每个缩略图左上角的复选框)
- **低置信度预测:**在任何图像上向下滚动可查看置信度值。低置信度 = AI 不确定
在小型数据集中,单个错误标签的影响巨大。如果只有 5 张训练图像,一个错误标签会污染 20% 的数据。在重新训练前务必反复检查每个标签,尤其是数据集较小时。
使用针对性数据进行重新训练
- 选择 AI 判断错误或不确定的图像
- 点击 "Add to Active Recipe Train Set"
- 如有需要,修正标签
- 点击 Retrain

专注于错判和低置信度的捕获,而不是随机的新数据。这是最高效的改进方式。
如果您需要查看 AI 对特定图像的具体预测结果,请将保存的 JPEG 上传到元数据查看器。OV 相机会将预测结果、置信度分数和相机设置直接嵌入到每张捕获的图像中。
随着数据集的增长,手动检查每个标签变得不切实际。Haystack 让您可以可视化地探索训练数据,将相似的图像聚类在一起,并快速发现看起来不合常规的标签。定期运行它以保持数据集的整洁。
分类器改进工作流程
- 审查库中的图像 → 查找错误和低置信度预测
- 将其添加到训练集
- 如有需要,重新标注
- 重新训练
- 使用 Haystack 可视化地探索数据,并大规模发现错误标注的图像
分割器改进工作流程
分割器的标注耗时更长(像素级标注),因此有一种捷径:
- 将有问题的图像导入分割程序
- 点击 Generate Predictions,让模型尽可能为新图像预先标注
- 修正预测结果,而不是从头开始标注(速度快得多)
- 重新训练
减少分割中的误报
如果您的分割器检测到许多本不该出现的随机小斑点,您有两种强大的工具可用:在通过/失败逻辑中过滤掉小斑点,以及训练模型更好地理解"正常"是什么样子。
使用最小尺寸阈值过滤掉小斑点
最快速的解决方法是让系统忽略低于特定像素面积的斑点。噪声斑点几乎总是比真实缺陷小得多,因此尺寸过滤器可以在不影响实际检测的情况下消除它们。
在 Basic Mode (IO 逻辑) 中:在通过/失败设置中设置最小斑点面积阈值。任何小于此像素数的斑点都将被完全忽略。从 50 像素之类的值开始,逐步调高,直到噪声消失但仍能触发真实缺陷。
**在 Advanced Mode (Node-RED) 中:**在 function 节点中按 blob.pixel_count 过滤斑点。例如,要忽略任何小于 50 像素的斑点:
const minBlobSize = 50;
const allBlobs = msg.payload.segmentation.blobs;
const realBlobs = allBlobs.filter(blob => blob.pixel_count >= minBlobSize);
const results = realBlobs.length <1; // Pass if no real blobs remain
msg.payload = results;
return msg;
根据您的应用调整 minBlobSize 值。查看调试输出中噪声斑点与真实缺陷的像素数对比,以找到合适的临界值。
将良好图像添加到训练集
这是减少误报检测最有效的方法,也是人们最常忽视的方法。
问题所在:如果您只用包含缺陷的图像进行训练,模型从未学习过干净零件的样子。它会在正常的表面纹理、光照渐变和细微变化中看到"缺陷"——也就是您正在对抗的所有小型随机斑点。
修复方法:
- 进入库并查找良好零件的图像——没有缺陷的干净表面
- 将这些图像添加到训练集(添加到活动程序训练集)
- 在标注视图中,选择 ROI 但不要添加任何缺陷标注。只需按原样包含它们,不做任何涂画标记
- 重新训练模型
通过向模型展示"正常"的样子,您正在教它停止将普通的表面变化标记为缺陷。这能显著减少噪声。
指导原则:
- 从 10-15 张良好图像开始并重新训练。测试结果
- 如果噪声持续存在,请添加更多。目标是至少 20-30 张良好图像与您的缺陷图像混合
- 如果您最初的训练集只包含带有缺陷的图像,这一点尤其重要
- 确保良好图像涵盖您在生产中看到的正常变化范围(不同的光照、轻微的颜色偏移、表面纹理)
十有八九,当有人抱怨到处出现随机小斑点时,根本原因是训练集中没有良好图像。添加它们并重新训练——改善通常是立竿见影且显著的。
减少噪声的其他技巧
- 提高光照一致性。 不一致的光照会产生阴影和高光,模型可能将其误认为缺陷。确保内置 LED 配置正确,且外部光源不会造成眩光或移动的阴影
- 检查模板对齐。 如果对齐器工作不佳,ROI 会在每次捕获之间发生偏移。模型每次看到不同的背景区域,这会增加噪声。验证对齐是否稳定
- 小步迭代。 添加 10-15 张良好图像,重新训练,测试。重复直到结果干净。这比一次性倒入 50 张图像并寄希望于最佳结果要快
理念
- 永不停止迭代。 AI 具有强大的学习能力,并且在 50、100 甚至 500+ 张图像下持续改进
- 有针对性地解决失败案例。 不要随机添加数据。添加 AI 难以处理的案例
- 定期检查错误标注。 随着数据集的增长,错误标注变得更难发现,但仍会损害准确性
使用 GenAI 工具加速
tools.overview.ai 上的三个 AI 驱动工具可以显著加快您的改进周期:
- Defect Studio —— 以比等待真实缺陷快 10,000 倍的速度生成逼真的合成缺陷图像
- Integration Builder —— 通过纯英文描述构建可投入生产的 Node-RED 流程
- AI Expert Helper —— 获得任何相机问题的 24/7 专家指导
这三个工具结合使用,可以将您的部署时间从数天缩短到数小时。生成合成训练数据而不是等待真实缺陷,通过描述您的需求来构建集成,并获得即时专家指导,无需等待支持工单。